Un negocio pocas veces guarda sus datos en un solo lugar. Las ventas están en una tienda en línea, los clientes en un CRM, el tráfico del sitio web en una herramienta de analítica y las cifras financieras en hojas de cálculo. Para responder una pregunta simple como "¿Qué canal de marketing nos trae a los mejores clientes?", alguien tiene que recopilar esos datos, limpiarlos y ponerlos en un lugar donde la gente pueda analizarlos.
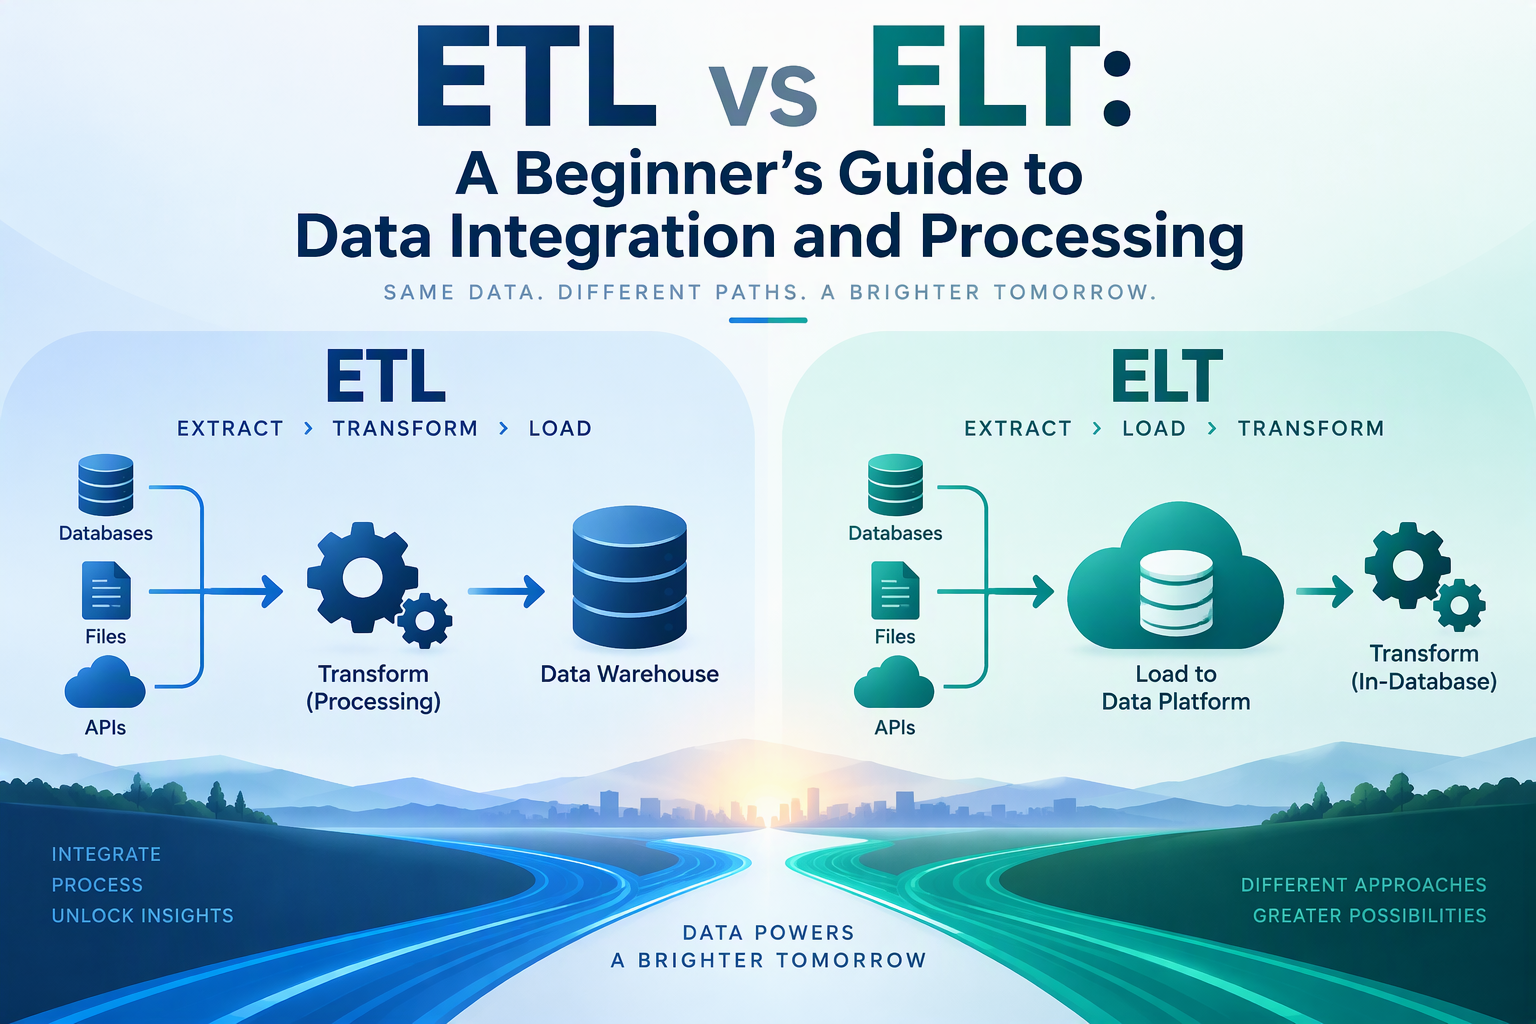
Ese trabajo se llama integración de datos, y los dos patrones más comunes para hacerlo son ETL y ELT. Usan los mismos tres pasos en un orden distinto, y esa pequeña diferencia cambia dónde se hace el trabajo, qué tan rápido obtienes los datos y cuánta flexibilidad tienes después. Esta guía explica ambos, los compara y muestra un ejemplo funcional de cada uno.
¿Qué Es la Integración de Datos?
La integración de datos consiste en combinar datos de distintas fuentes en una forma consistente y utilizable, normalmente en un lugar central como una base de datos o un almacén de datos (data warehouse). Un almacén es una base de datos creada para el análisis y los informes, no para ejecutar una aplicación.
Una vez que los datos están ahí, los analistas pueden consultarlos, crear paneles y responder preguntas sin tocar los sistemas que el negocio usa todos los días. Si eres nuevo en el rol que usa estos datos, lee qué hace un analista de datos.
¿Qué Es ETL?
ETL significa Extract, Transform, Load (Extraer, Transformar, Cargar):
- Extraer: sacar los datos de los sistemas de origen (bases de datos, archivos, APIs, aplicaciones).
- Transformar: limpiarlos y darles forma antes de guardarlos: corregir formatos, eliminar duplicados, combinar fuentes, calcular campos nuevos.
- Cargar: escribir los datos ya limpios y terminados en el destino.
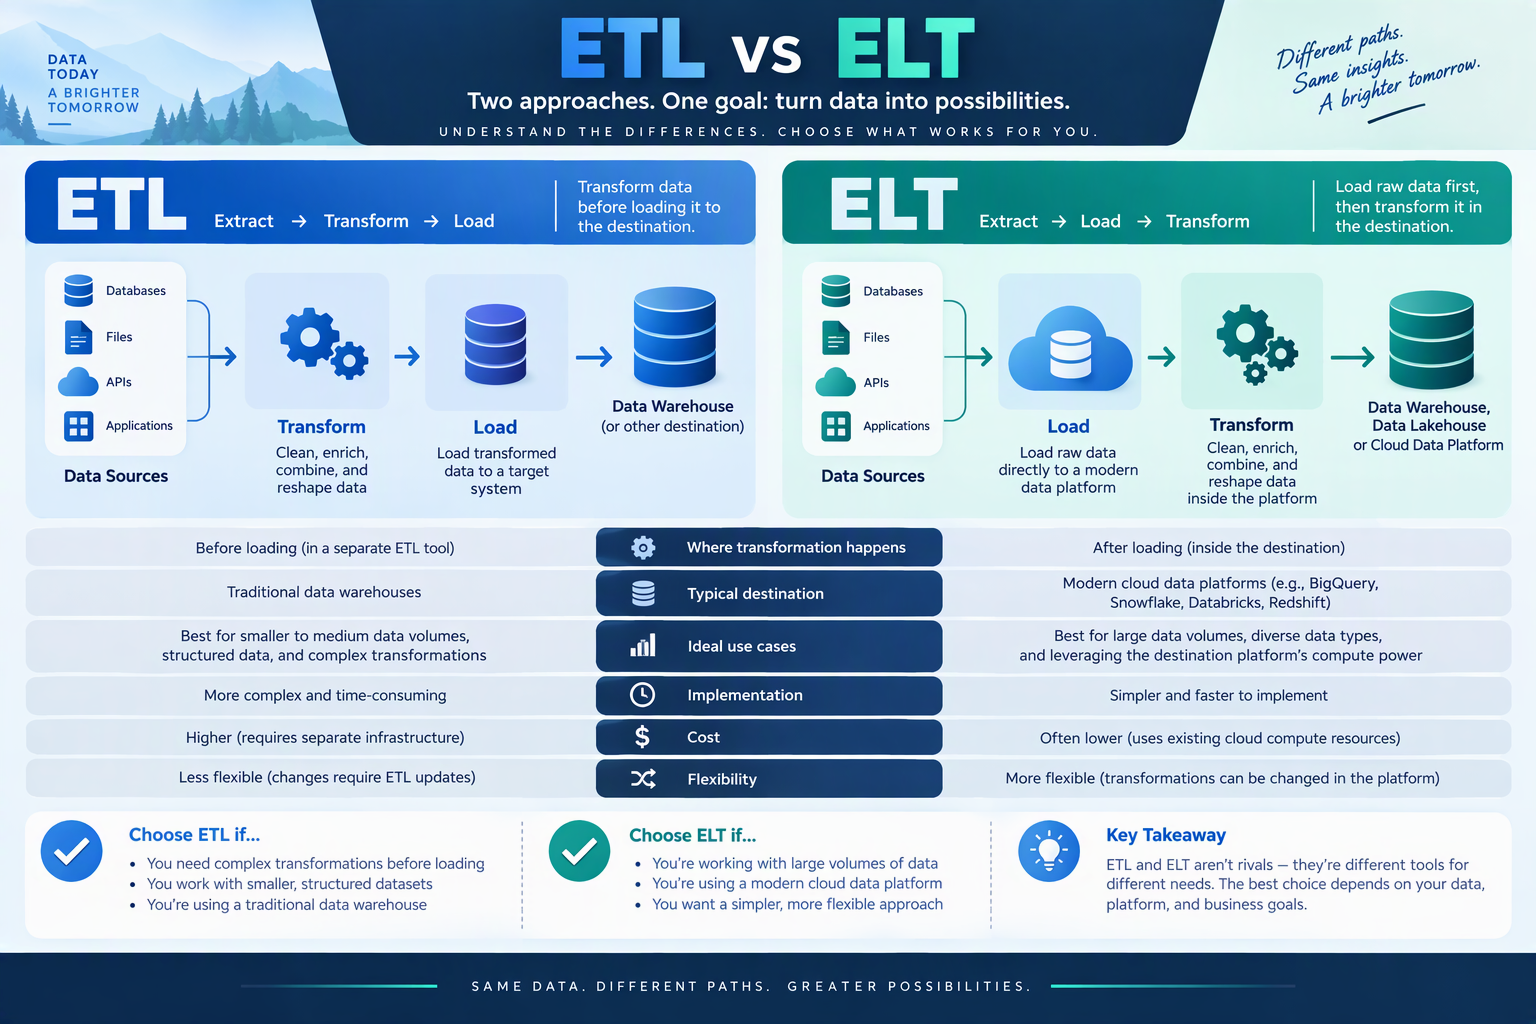
Sistemas de origen → Extraer → Transformar (en un servidor aparte) → Cargar → Almacén
En ETL, la transformación ocurre en un paso de procesamiento separado, con un script, un servidor o una herramienta ETL, antes de que algo llegue al almacén. El almacén solo recibe datos ordenados y listos para usar.
¿Qué Es ELT?
ELT significa Extract, Load, Transform (Extraer, Cargar, Transformar). Los dos últimos pasos intercambian lugares:
- Extraer: sacar los datos de las fuentes.
- Cargar: escribir los datos sin procesar directamente en el destino, con pocos cambios o ninguno.
- Transformar: usar la propia capacidad de procesamiento del destino (normalmente SQL) para limpiar y dar forma a los datos después de cargarlos.
Sistemas de origen → Extraer → Cargar (sin procesar) → Transformar (dentro del almacén)
ELT se hizo popular con los almacenes de datos en la nube, como BigQuery, Snowflake y Redshift, y con los data lakes, que pueden almacenar enormes volúmenes de datos sin procesar a bajo costo y procesarlos rápidamente. Como el almacén es potente y el almacenamiento es barato, a menudo tiene sentido cargar todo primero y decidir después cómo transformarlo.
ETL vs ELT: Las Diferencias Clave
| ETL | ELT | |
|---|---|---|
| Orden de los pasos | Extraer → Transformar → Cargar | Extraer → Cargar → Transformar |
| Dónde ocurre la transformación | En un motor de procesamiento o script separado | Dentro de la base de datos o almacén de destino |
| Qué se guarda | Solo datos limpios y transformados | Datos sin procesar, más las tablas transformadas |
| Velocidad para tener los primeros datos | Más lenta, porque la transformación debe terminar primero | Más rápida, porque cargar es sencillo |
| Flexibilidad | Cambiar una transformación implica volver a ejecutar el flujo | Los datos sin procesar se conservan, así que puedes transformarlos de nuevo cuando quieras |
| Lenguajes típicos | Python, Java o interfaces de herramientas ETL | SQL |
| Funciona mejor con | Bases de datos tradicionales, datos pequeños, reglas estrictas | Almacenes en la nube y data lakes, datos grandes o variados |
| Privacidad de datos | Los campos sensibles pueden eliminarse o enmascararse antes de cargar | Los datos sin procesar, incluidos los campos sensibles, llegan al almacén, por lo que hay que controlar el acceso |
| Perfil de costos | Necesita un servidor de transformación aparte | Usa el cómputo del almacén, que pagas por consulta o por hora |
Ninguno es “mejor”. Son herramientas distintas para situaciones distintas.
Una Analogía Sencilla
Imagina que preparas una ensalada para un gran evento:
- ETL es como lavar, picar y mezclar todo en la cocina y llevar a la mesa solo la ensalada terminada. Los invitados reciben exactamente lo que preparaste, pero tú decidiste la receta de antemano.
- ELT es como llevar todos los ingredientes frescos a la mesa y dejar que cada invitado pique y mezcle los suyos. Es más rápido para empezar y flexible, pero necesitas buenas herramientas, una mesa limpia y algunas reglas sobre quién toca qué.
En la Práctica: ETL en Python
Aquí hay un ejemplo pequeño y realista. Supón que recibes este orders.csv desordenado:
order_id,customer,order_date,amount
1, Ana ,2025-01-05,$35.50
2,LUIS,2025-01-06,$120.00
2,LUIS,2025-01-06,$120.00
3,Marta,2025-01-07,
4,Pedro,not a date,$19.99
Tiene espacios extra, mayúsculas inconsistentes, una fila duplicada, signos de dólar en los montos, un monto faltante y una fecha inválida. Este script ETL lo limpia con pandas antes de cargarlo en una base de datos. (Instala las bibliotecas con pip install pandas sqlalchemy. Para saber más sobre los métodos de pandas, consulta limpieza de datos con Python Pandas.)
import pandas as pd
from sqlalchemy import create_engine

# Extraer
raw = pd.read_csv("orders.csv")

# Transformar
clean = (
    raw.drop_duplicates()
       .assign(
           customer=lambda d: d["customer"].str.strip().str.title(),
           order_date=lambda d: pd.to_datetime(d["order_date"], errors="coerce"),
           amount=lambda d: pd.to_numeric(
               d["amount"].str.replace("$", "", regex=False), errors="coerce"
           ),
       )
       .dropna(subset=["order_date", "amount"])
)

# Cargar
engine = create_engine("sqlite:///warehouse.db")
clean.to_sql("orders", engine, if_exists="replace", index=False)
El resultado es una tabla con dos filas limpias:
   order_id customer order_date  amount
0         1      Ana 2025-01-05    35.5
1         2     Luis 2025-01-06   120.0
Observa lo que pasó: las filas malas (sin monto, fecha inválida) se descartaron antes de cargar, así que la base de datos nunca las ve. Para aprender a leer datos desde archivos, APIs y bases de datos, consulta Python para análisis de datos: cómo acceder a tus datos.
En la Práctica: ELT con SQL
Ahora el mismo trabajo como ELT. Primero, carga el archivo tal cual y luego límpialo dentro de la base de datos con SQL:
import pandas as pd
from sqlalchemy import create_engine, text

engine = create_engine("sqlite:///warehouse.db")

# Extraer + Cargar: los datos sin procesar entran intactos
raw = pd.read_csv("orders.csv")
raw.to_sql("raw_orders", engine, if_exists="replace", index=False)

# Transformar: la base de datos hace el trabajo
with engine.begin() as conn:
    conn.execute(text("DROP TABLE IF EXISTS orders_clean"))
    conn.execute(text("""
        CREATE TABLE orders_clean AS
        SELECT DISTINCT
            order_id,
            UPPER(SUBSTR(TRIM(customer), 1, 1)) || LOWER(SUBSTR(TRIM(customer), 2)) AS customer,
            DATE(order_date) AS order_date,
            CAST(REPLACE(amount, '$', '') AS REAL) AS amount
        FROM raw_orders
        WHERE amount IS NOT NULL
          AND DATE(order_date) IS NOT NULL
    """))
La tabla orders_clean termina con las mismas dos filas. La diferencia es que raw_orders sigue conteniendo todas las filas originales, incluidas las malas. Si tus reglas cambian el próximo mes, por ejemplo si decides conservar los pedidos sin monto, solo reescribes el SQL y reconstruyes la tabla limpia. No necesitas extraer los datos otra vez.
Este ejemplo usa SQLite. Otras bases de datos usan nombres de funciones ligeramente distintos (por ejemplo, PostgreSQL tiene INITCAP() para poner en mayúscula los nombres), pero la idea es la misma. Para más técnicas de limpieza con SQL, consulta limpiar datos desordenados con SQL.
Los Tres Pasos en Detalle
Extraer
Extraer significa sacar los datos de su origen. Las fuentes comunes incluyen:
- Bases de datos como MySQL, PostgreSQL y SQL Server (consulta la guía de PostgreSQL)
- Archivos como CSV, Excel, JSON y Parquet
- APIs de servicios como procesadores de pago, CRM y plataformas de publicidad
- Páginas web, mediante web scraping
- Registros y flujos de eventos de aplicaciones y sitios web
Puedes extraer todo cada vez (una carga completa) o solo lo que cambió desde la última vez (una carga incremental). Las cargas incrementales son más rápidas y baratas cuando los datos crecen.
Transformar
Las transformaciones típicas incluyen:
- Limpieza: corregir formatos, recortar espacios, manejar valores faltantes, eliminar duplicados
- Estandarización: formatos de fecha, monedas, unidades y ortografía consistentes
- Unión: combinar tablas de distintas fuentes (consulta JOINs de SQL explicados)
- Agregación: totales y promedios por día, producto o cliente
- Derivación: columnas nuevas como “valor de vida del cliente” o “días desde el último pedido”
- Validación: comprobar que los datos cumplan reglas, como cantidades no negativas
Cargar
Cargar escribe los datos en su destino. Puedes reemplazar una tabla cada vez, agregar filas nuevas o hacer un upsert, que actualiza las filas existentes e inserta las nuevas. El buen diseño de las tablas de destino importa, así que consulta diseño de bases de datos.
Cuándo Elegir ETL
ETL es una buena opción cuando:
- Necesitas eliminar o enmascarar datos sensibles antes de que lleguen al almacén, por ejemplo por razones de privacidad o cumplimiento
- El destino es una base de datos tradicional que no puede manejar transformaciones pesadas
- El volumen de datos es pequeño o moderado y la lógica es compleja o requiere un lenguaje de programación
- Tienes reglas estrictas de calidad de datos y quieres guardar solo datos validados
- El sistema de destino necesita los datos en un formato específico y fijo
Cuándo Elegir ELT
ELT es una buena opción cuando:
- Usas un almacén de datos en la nube o un data lake con mucha capacidad de procesamiento
- Trabajas con datos grandes o de rápido crecimiento
- Quieres flexibilidad: los analistas pueden crear nuevas vistas a partir de los datos sin procesar sin pedir a los ingenieros que cambien el flujo
- Quieres acceso más rápido a los datos, agregando transformaciones poco a poco
- Tu equipo se siente cómodo con SQL
Muchos sistemas reales usan una mezcla de ambos: un paso ligero de limpieza y enmascaramiento antes de cargar (un poco de ETL) y la mayor parte del modelado en el almacén (ELT).
Herramientas Comunes
No necesitas todas, pero verás estos nombres:
| Tipo | Ejemplos | Qué hacen |
|---|---|---|
| Bibliotecas de Python | pandas, SQLAlchemy | Scripts ETL hechos a mano, ideales para aprender y trabajos pequeños |
| Herramientas ETL tradicionales | Informatica, Talend, SQL Server Integration Services (SSIS) | Herramientas visuales para construir flujos ETL |
| Herramientas ELT y de ingesta | Fivetran, Airbyte, Stitch | Conectores que copian datos de aplicaciones a un almacén |
| Herramientas de transformación | dbt | Permite a los equipos escribir transformaciones SQL con control de versiones y pruebas |
| Orquestadores | Apache Airflow, Prefect, Dagster | Programan y monitorean los flujos |
| Almacenes y lagos en la nube | BigQuery, Snowflake, Redshift, Azure Synapse | Almacenan datos y ejecutan las transformaciones en ELT |
| Automatización low-code | Power Automate y similares | Movimientos simples de datos entre aplicaciones de negocio (consulta Power Automate para incorporación de empleados) |
Privacidad y Seguridad de Datos en los Flujos
Mover datos genera riesgo, así que incorpora protección a tu flujo:
- Extrae solo lo que necesitas. No copies columnas sensibles “por si acaso”. Sigue la misma idea de minimización de datos de qué es la privacidad de datos.
- Enmascara o elimina los campos sensibles temprano (una ventaja de ETL), o restringe quién puede ver las tablas sin procesar (esencial en ELT).
- Cifra los datos en tránsito y en reposo y protege las credenciales. Nunca escribas contraseñas directamente en los scripts. Consulta seguridad y privacidad de bases de datos.
- Limita el acceso con mínimo privilegio: los flujos deben usar cuentas que solo puedan tocar lo que necesitan.
- Registra lo que se ejecuta y vigila los fallos y los volúmenes inusuales.
- Elimina las copias antiguas sin procesar según tu política de retención.
Errores Comunes que Debes Evitar
- Cargar sin revisar la calidad. Datos malos de entrada significan informes malos de salida. Agrega comprobaciones de valores faltantes, duplicados y números imposibles.
- Flujos que no son repetibles. Ejecutar un trabajo dos veces no debe crear filas duplicadas. Diseña las cargas para que puedan ejecutarse de nuevo con seguridad (reemplazar o hacer upsert en lugar de agregar a ciegas).
- Ignorar cambios de esquema. Una fuente agrega o renombra una columna y tu flujo se rompe en silencio. Monitoréalo.
- Sobrescribir tu única copia. Conserva los datos sin procesar, ya sea en una tabla cruda (ELT) o en un archivo (ETL), para poder reconstruir cuando cambie la lógica.
- Sin monitoreo ni alertas. Un flujo que falla en silencio es peor que uno que falla con ruido.
- Rutas y contraseñas escritas directamente. Usa configuración y variables de entorno.
- Sobreingeniería. Un negocio pequeño con tres hojas de cálculo no necesita una plataforma empresarial. Un script de Python programado puede ser suficiente.
Cómo Empezar
- Elige un proyecto pequeño y real. Por ejemplo, combina un CSV de ventas y un CSV de clientes en una sola tabla limpia.
- Escribe un script ETL sencillo en Python como el de arriba y ejecútalo de forma programada.
- Repítelo como ELT: carga los datos sin procesar en una base de datos como PostgreSQL o SQLite y escribe la limpieza en SQL.
- Compara los dos. Fíjate qué es más fácil o más difícil en cada uno.
- Agrega comprobaciones y registros y luego aprende un programador o una herramienta como dbt cuando tus proyectos crezcan.
Conclusión
ETL y ELT mueven los datos de donde se crean a donde pueden usarse, en tres pasos: extraer, transformar y cargar. En ETL, limpias los datos antes de guardarlos, lo que conviene a datos más pequeños, reglas estrictas y necesidades de privacidad. En ELT, cargas primero los datos sin procesar y los transformas dentro de un almacén potente, lo que conviene a datos grandes y a un análisis flexible basado en SQL.
La mayoría de los equipos modernos se inclina por ELT para analítica y usa ideas de ETL donde necesita control. La mejor forma de entender la diferencia es construir ambos con un conjunto de datos pequeño, como en los ejemplos de arriba. Cuando hayas visto el mismo archivo desordenado limpiado en Python y en SQL, las ventajas y desventajas tendrán sentido.