
Si trabajas con números en Python (cifras de ventas, lecturas de sensores, resultados de encuestas, imágenes o datos de aprendizaje automático), vas a usar NumPy, te des cuenta o no. Es la base de todo el ecosistema de datos de Python: Pandas está construido encima de NumPy, Matplotlib grafica sus arreglos, y bibliotecas como scikit-learn, SciPy y PyTorch hablan su mismo idioma.
NumPy le da a Python un nuevo tipo de dato muy poderoso, el arreglo (array), y una enorme biblioteca de funciones rápidas para trabajar con él. Con unas cuantas líneas de NumPy puedes hacer cálculos con millones de números a la vez, normalmente decenas de veces más rápido que con las listas normales de Python.
Esta guía enseña NumPy desde cero: cómo funcionan los arreglos, cómo crear, seleccionar y filtrar datos, cómo hacer cálculos con arreglos completos a la vez, y dos ideas que hacen que NumPy cobre sentido: los ejes y el broadcasting. Termina con ejemplos del mundo real y los errores que más confunden a los principiantes. Cada ejemplo muestra su resultado real, para que puedas seguirlo y comprobar tus resultados.
¿Qué Es NumPy?
NumPy (abreviatura de “Numerical Python”, Python numérico) es una biblioteca gratuita y de código abierto para trabajar con números. Su núcleo es el ndarray (arreglo de n dimensiones): una cuadrícula de valores, todos del mismo tipo, guardados de forma eficiente en la memoria.
Esa única decisión de diseño (todos los valores de un arreglo tienen el mismo tipo y se guardan uno junto a otro) es lo que hace rápido a NumPy. Una lista de Python puede contener cualquier cosa (números, texto, otras listas), así que Python tiene que revisar el tipo de cada elemento cada vez que hace algo con él. Un arreglo de NumPy sabe que todos sus valores son, por ejemplo, números decimales de 64 bits, así que sus operaciones se ejecutan en código compilado y rápido, en lugar de un ciclo lento de Python.
Instalar e Importar NumPy
Instala NumPy en un entorno virtual (o con uv). Si ya instalaste Pandas, ya lo tienes.
pip install numpy
Por convención, NumPy siempre se importa como np:
import numpy as np

prices = np.array([19.99, 49.00, 9.99, 300.00, 1200.00])
print(prices)
print(prices * 1.0775)
[  19.99   49.      9.99  300.   1200.  ]
[  21.539225   52.7975     10.764225  323.25     1293.      ]
Esa segunda línea es el corazón de NumPy: multiplicar el arreglo por 1.0775 aplica un impuesto del 7.75% a todos los precios a la vez, sin necesidad de un ciclo.
Versiones: los resultados de esta guía son de NumPy 2.5, y cada ejemplo produce exactamente el mismo resultado en NumPy 1.26.
Arreglos vs. Listas de Python
Los arreglos y las listas se parecen, pero se comportan de forma muy distinta. Compáralos lado a lado:
prices_list = [19.99, 49.00, 9.99, 300.00, 1200.00]
print([p * 2 for p in prices_list])
print(prices * 2)
print(prices_list + prices_list)
print(prices + prices)
[39.98, 98.0, 19.98, 600.0, 2400.0]
[  39.98   98.     19.98  600.   2400.  ]
[19.99, 49.0, 9.99, 300.0, 1200.0, 19.99, 49.0, 9.99, 300.0, 1200.0]
[  39.98   98.     19.98  600.   2400.  ]
- Para duplicar cada número de una lista, necesitas un ciclo o una comprensión de lista (consulta Fundamentos de Python: Listas y Diccionarios). Con un arreglo,
prices * 2lo hace directamente. - En las listas,
+significa unir: el resultado es una lista del doble de largo. En los arreglos,+significa sumar, elemento por elemento.
Aplicar una operación a todos los elementos a la vez se llama vectorización, y no solo es más corto: es mucho más rápido. Esta es una prueba de tiempo rápida que puedes ejecutar tú mismo, duplicando un millón de números:
import timeit

setup = "import numpy as np; data = list(range(1_000_000)); arr = np.arange(1_000_000)"
t_list = min(timeit.repeat("[x * 2 for x in data]", setup=setup, number=10, repeat=5)) / 10
t_np = min(timeit.repeat("arr * 2", setup=setup, number=10, repeat=5)) / 10
print(f"List: {t_list*1000:.1f} ms")
print(f"NumPy: {t_np*1000:.2f} ms")
print(f"NumPy is about {t_list/t_np:.0f}x faster")
En mi computadora, imprimió:
List: 58.1 ms
NumPy: 1.28 ms
NumPy is about 45x faster
Tus números exactos serán distintos, pero NumPy suele ser decenas de veces más rápido en este tipo de trabajo, y la diferencia crece con cálculos más complejos.
Crear Arreglos
Además de convertir una lista con np.array(), NumPy tiene funciones para crear directamente los arreglos más comunes:
print(np.zeros(5))
print(np.ones((2, 3)))
print(np.full(3, 7))
print(np.arange(0, 10, 2))
print(np.linspace(0, 1, 5))
[0. 0. 0. 0. 0.]
[[1. 1. 1.]
 [1. 1. 1.]]
[7 7 7]
[0 2 4 6 8]
[0.   0.25 0.5  0.75 1.  ]
np.zeros()ynp.ones()crean arreglos llenos de ceros o de unos. Pasa una tupla como(2, 3)para 2 filas y 3 columnas.np.full()llena un arreglo con cualquier valor.np.arange(inicio, fin, paso)funciona como elrange()de Python, pero devuelve un arreglo.np.linspace(inicio, fin, cantidad)crea valores igualmente espaciados, incluido el punto final. Úsalo cuando sabes cuántos valores quieres en lugar del tamaño del paso.
Números Aleatorios
Para simulaciones, pruebas y datos de ejemplo, usa un generador de números aleatorios. Darle una semilla (seed) hace que los números “aleatorios” sean los mismos cada vez que ejecutas el código, así tus resultados se pueden reproducir:
rng = np.random.default_rng(seed=42)
print(rng.integers(1, 7, size=10))
print(rng.random(3).round(3))
print(rng.normal(loc=100, scale=15, size=4).round(1))
[1 5 4 3 3 6 1 5 2 1]
[0.976 0.761 0.786]
[ 99.7  87.2 113.2 111.7]
rng.integers(1, 7, size=10)lanza diez dados de seis caras (el límite superior, 7, no se incluye).rng.random()devuelve decimales entre 0 y 1.rng.normal()saca valores de una curva de campana; aquí, con un promedio de 100 y una desviación estándar de 15.
Con la misma semilla (42) obtendrás exactamente estos números. default_rng() es la forma moderna de generar números aleatorios; los tutoriales más antiguos usan np.random.seed() y np.random.randint(), que todavía funcionan pero no se recomiendan para código nuevo.
El Conjunto de Datos de Ejemplo: Ventas de Tiendas
Durante la mayor parte de esta guía usaremos las ventas diarias de tres tiendas (Downtown, Airport y Mall) durante cinco días, de lunes a viernes. Cada fila es una tienda y cada columna es un día:
sales = np.array([
    [120, 135, 150, 110, 190],
    [ 80,  95,  70,  85, 130],
    [200, 210, 180, 220, 260],
])
print(sales.shape)
print(sales.ndim)
print(sales.size)
print(sales.dtype)
(3, 5)
2
15
int64
Estos cuatro atributos describen cualquier arreglo:
shape(forma): el tamaño de cada dimensión: 3 filas y 5 columnas.ndim: la cantidad de dimensiones: 2, porque es una tabla.size: la cantidad total de valores: 15.dtype: el tipo de dato de todos los valores:int64, un entero de 64 bits.
Tipos de Datos (dtype)
NumPy elige un tipo de dato automáticamente según tus valores, pero también puedes definirlo tú:
print(np.array([1, 2, 3]).dtype)
print(np.array([1, 2, 3.5]).dtype)
print(np.array([1, 2, 3], dtype=np.float32).dtype)
print(np.array(["a", "b"]).dtype)
int64
float64
float32
<U1
Como todos los valores de un arreglo deben tener el mismo tipo, un solo número decimal convierte todo el arreglo en flotantes (float64). Los tipos más pequeños, como float32 o int8, usan menos memoria, lo que importa con arreglos muy grandes. <U1 significa texto Unicode de longitud 1: NumPy puede guardar texto, pero para datos con mucho texto, Pandas es la mejor herramienta. (En Windows con NumPy 1.x, el tipo entero predeterminado es int32 en lugar de int64.)
Acceder a los Elementos y Rebanar
Arreglos de Una Dimensión
Acceder a los elementos de un arreglo de una dimensión y rebanarlo funciona igual que con una lista de Python:
x = np.array([10, 20, 30, 40, 50])
print(x[0], x[-1])
print(x[1:4])
print(x[::2])
10 50
[20 30 40]
[10 30 50]
Arreglos de Dos Dimensiones
En un arreglo de dos dimensiones, indica primero la fila y después la columna, separadas por una coma:
print(sales[0])
print(sales[0, 4])
print(sales[:, 4])
print(sales[1:, :2])
[120 135 150 110 190]
190
[190 130 260]
[[ 80  95]
 [200 210]]
sales[0]es la primera fila: todas las ventas de Downtown.sales[0, 4]es un solo valor: Downtown el viernes.sales[:, 4]usa:para decir “todas las filas”, y da la cuarta columna: las ventas del viernes de todas las tiendas.sales[1:, :2]combina dos rebanadas: las filas de Airport y Mall, para el lunes y el martes.
Vistas vs. Copias
Esta es una de las diferencias más importantes con las listas de Python. Rebanar un arreglo no copia los datos: crea una vista, una ventana a la misma memoria. Cambiar la vista cambia el original:
first_two = x[:2]
first_two[0] = 999
print(x)

x = np.array([10, 20, 30, 40, 50])
safe = x[:2].copy()
safe[0] = 999
print(x)
[999  20  30  40  50]
[10 20 30 40 50]
Las vistas hacen que NumPy sea rápido y eficiente con la memoria, porque rebanar un arreglo enorme no lo duplica. Pero si quieres cambiar una rebanada sin afectar el original, llama a .copy().
Filtrar con Máscaras Booleanas
Una comparación con un arreglo devuelve un arreglo de valores True y False, llamado máscara booleana:
print(sales > 150)
print(sales[sales > 150])
print((sales > 150).sum())
print(sales[(sales >= 100) & (sales <= 130)])
[[False False False False  True]
 [False False False False False]
 [ True  True  True  True  True]]
[190 200 210 180 220 260]
6
[120 110 130]
- Poner una máscara dentro de los corchetes conserva solo los valores donde la máscara es
True. - Como
Truecuenta como 1 yFalsecomo 0,.sum()sobre una máscara cuenta las coincidencias: 6 días tuvieron ventas mayores que 150. - Combina condiciones con
&(y),|(o) y~(no), con paréntesis alrededor de cada condición. Elandy elorde Python no funcionan con arreglos.
Elegir Valores con np.where()
np.where(condición, valor_si_es_verdadera, valor_si_es_falsa) funciona como una sentencia if aplicada a cada elemento:
print(np.where(sales > 150, "high", "normal"))
print(np.where(sales < 100, 100, sales))
[['normal' 'normal' 'normal' 'normal' 'high']
 ['normal' 'normal' 'normal' 'normal' 'normal']
 ['high' 'high' 'high' 'high' 'high']]
[[120 135 150 110 190]
 [100 100 100 100 130]
 [200 210 180 220 260]]
El segundo ejemplo sube a 100 todos los valores menores que 100 y deja todo lo demás igual.
Seleccionar con Listas de Posiciones
También puedes pasar una lista de posiciones para elegir filas (o valores) en cualquier orden. Esto se llama indexación sofisticada (fancy indexing) y es útil para buscar etiquetas que corresponden a tus datos:
stores = np.array(["Downtown", "Airport", "Mall"])
print(sales[[2, 0]])
print(stores[[2, 0]])
[[200 210 180 220 260]
 [120 135 150 110 190]]
['Mall' 'Downtown']
Cálculos Vectorizados
Todos los operadores aritméticos funcionan elemento por elemento, y NumPy incluye cientos de funciones universales (ufuncs) para hacer cálculos:
celsius = np.array([-10, 0, 20, 37])
print(celsius * 9 / 5 + 32)
print(np.sqrt([4, 9, 16]))
print(np.round(np.array([1.234, 5.678]), 1))
[14.  32.  68.  98.6]
[2. 3. 4.]
[1.2 5.7]
Toda la fórmula para convertir de Celsius a Fahrenheit se aplica a todas las temperaturas a la vez. Otras funciones comunes son np.abs(), np.exp(), np.log(), np.sin() y np.floor().
Agregaciones y el Parámetro axis
Las agregaciones reducen muchos valores a uno solo:
print(sales.sum())
print(sales.mean().round(2))
print(sales.max(), sales.min())
print(sales.std().round(2))
2235
149.0
260 70
56.13
Estas resumen los 15 valores: ventas totales de 2,235, un día promedio de 149, un mejor día de 260, un peor día de 70 y una desviación estándar (qué tan dispersos están los valores) de 56.13.
Entender axis
Normalmente quieres los totales por tienda o por día, no de todo junto. Para eso sirve el parámetro axis (eje), y es el concepto que más confunde a los principiantes. Esta es la forma más sencilla de pensarlo: axis es la dirección que se colapsa.
              axis=1 → (a lo largo de las columnas)
              Lun  Mar  Mié  Jue  Vie
Downtown    [ 120  135  150  110  190 ]   sum(axis=1) → un total por tienda
Airport     [  80   95   70   85  130 ]
Mall        [ 200  210  180  220  260 ]
   ↓
axis=0 (hacia abajo, por las filas) → sum(axis=0) da un total por día
print(sales.sum(axis=1))
print(sales.sum(axis=0))
print(sales.mean(axis=0))
[ 705  460 1070]
[400 440 400 415 580]
[133.33333333 146.66666667 133.33333333 138.33333333 193.33333333]
axis=1colapsa las columnas y deja un valor por fila: el total semanal de cada tienda. Mall vendió 1,070.axis=0colapsa las filas y deja un valor por columna: el total de cada día entre todas las tiendas. El viernes fue el mejor día, con 580.
Encontrar Dónde Están las Cosas: argmax y cumsum
print(stores[sales.sum(axis=1).argmax()])
print(sales.argmax(axis=1))
print(np.cumsum(sales[0]))
Mall
[4 4 4]
[120 255 405 515 705]
argmax()devuelve la posición del valor más grande, en lugar del valor en sí. Junto con el arreglostores, responde “¿qué tienda vendió más?” en una sola línea.sales.argmax(axis=1)encuentra el mejor día de cada tienda: la posición 4 (viernes) para las tres.np.cumsum()devuelve un total acumulado: Downtown había vendido 405 para el miércoles y 705 para el viernes.
Broadcasting
El broadcasting (difusión) es la forma en que NumPy hace cálculos entre arreglos de formas distintas. Es lo que hace posible muchos cálculos en una sola línea.
Un Arreglo y un Solo Número
El caso más sencillo: un solo número se aplica a todos los elementos.
print(sales * 2)
[[240 270 300 220 380]
 [160 190 140 170 260]
 [400 420 360 440 520]]
Un Arreglo y una Fila
Si sumas un arreglo de una dimensión con 5 valores a nuestra tabla de 3×5, NumPy estira la fila hacia abajo para que se sume a todas las tiendas. Aquí se agrega un bono por las promociones del jueves y del viernes:
day_bonus = np.array([0, 0, 0, 10, 25])
print(sales + day_bonus)
[[120 135 150 120 215]
 [ 80  95  70  95 155]
 [200 210 180 230 285]]
Un Arreglo y una Columna
Para aplicar un valor distinto a cada fila, usa una columna: un arreglo con forma (3, 1). Aquí, las ventas de cada tienda se dividen entre su propia meta diaria para ver qué tan cerca estuvo:
targets = np.array([[150], [100], [200]])
print((sales / targets).round(2))
[[0.8  0.9  1.   0.73 1.27]
 [0.8  0.95 0.7  0.85 1.3 ]
 [1.   1.05 0.9  1.1  1.3 ]]
Un resultado de 1.27 significa el 127% de la meta: todas las tiendas superaron su meta el viernes.
La Regla del Broadcasting
NumPy compara las dos formas desde la derecha. Dos dimensiones son compatibles si son iguales, o si una de ellas es 1 (en ese caso se estira). Las dimensiones que faltan a la izquierda cuentan como 1.
| Formas | ¿Compatibles? | Por qué |
|---|---|---|
(3, 5) y un solo número | Sí | Un solo número funciona con cualquier forma |
(3, 5) y (5,) | Sí | Las últimas dimensiones coinciden (5 y 5) |
(3, 5) y (3, 1) | Sí | 5 vs. 1: el 1 se estira; 3 vs. 3 coinciden |
(3, 5) y (3,) | No | 5 y 3 no coinciden, y ninguno es 1 |
Ese último caso es un error común: intentar sumar un valor por tienda usando un arreglo plano:
try:
    sales + np.array([1, 2, 3])
except ValueError as error:
    print("ValueError:", error)
ValueError: operands could not be broadcast together with shapes (3,5) (3,)
La solución es convertirlo en una columna, ya sea con np.array([[1], [2], [3]]) o con np.array([1, 2, 3])[:, np.newaxis], que le da la forma (3, 1).
El Broadcasting en Acción: Normalizar los Datos
El broadcasting y los ejes se unen en una tarea muy común: estandarizar los datos en puntuaciones z (z-scores), que muestran qué tan lejos está cada valor del promedio de su fila, en desviaciones estándar. Aquí responde “¿qué días fueron inusualmente buenos o malos para cada tienda?”, aunque las tiendas tengan niveles de ventas muy distintos:
store_mean = sales.mean(axis=1, keepdims=True)
store_std = sales.std(axis=1, keepdims=True)
z = (sales - store_mean) / store_std
print(z.round(2))
[[-0.75 -0.21  0.32 -1.11  1.75]
 [-0.58  0.15 -1.07 -0.34  1.84]
 [-0.53 -0.15 -1.28  0.23  1.73]]
keepdims=True conserva los resultados como columnas, con forma (3, 1), para que se difundan correctamente contra la tabla de (3, 5). El resultado muestra que el viernes estuvo muy por encima de lo normal en todas las tiendas (entre +1.7 y +1.8), mientras que el jueves fue el día más flojo de Downtown.
Cambiar la Forma y Combinar Arreglos
Cambiar la Forma
y = np.arange(12)
print(y.reshape(3, 4))
print(y.reshape(2, -1))
print(sales.T)
print(sales.flatten()[:6])
[[ 0  1  2  3]
 [ 4  5  6  7]
 [ 8  9 10 11]]
[[ 0  1  2  3  4  5]
 [ 6  7  8  9 10 11]]
[[120  80 200]
 [135  95 210]
 [150  70 180]
 [110  85 220]
 [190 130 260]]
[120 135 150 110 190  80]
reshape()reorganiza los mismos valores en una forma nueva. La cantidad total de valores debe ser la misma: 12 valores pueden ser 3×4 o 2×6, pero no 5×5.-1significa “calcula tú esta dimensión”..Ttranspone el arreglo, intercambiando filas y columnas: ahora cada fila es un día..flatten()convierte cualquier arreglo de vuelta en una sola dimensión.
Apilar Arreglos
week2 = sales + 10
print(np.vstack([sales, week2]).shape)
print(np.hstack([sales, week2]).shape)
print(np.concatenate([sales, week2], axis=0).shape)
(6, 5)
(3, 10)
(6, 5)
np.vstack() apila los arreglos verticalmente (más filas), np.hstack() los apila horizontalmente (más columnas) y np.concatenate() hace cualquiera de las dos, según el axis.
Errores Comunes
Valores Faltantes (NaN)
NumPy representa los números faltantes o indefinidos con np.nan (“not a number”, no es un número). Un solo nan hace que las agregaciones normales devuelvan nan:
readings = np.array([22.5, 23.1, np.nan, 24.0])
print(readings.mean())
print(np.nanmean(readings))
print(np.isnan(readings))
nan
23.2
[False False  True False]
Usa las versiones que ignoran los nan (np.nanmean(), np.nansum(), np.nanmax(), etc.) para no tomar en cuenta los valores faltantes, y np.isnan() para encontrarlos. (Nunca uses == np.nan para buscar valores faltantes: nan no es igual a nada, ni siquiera a sí mismo.)
Comparar Números Decimales
Como viste en Fundamentos de Python: Variables y Tipos de Datos, las operaciones con decimales no son perfectamente precisas:
print(0.1 + 0.2 == 0.3)
print(np.isclose(0.1 + 0.2, 0.3))
False
True
Usa np.isclose() (o np.allclose() para arreglos completos) para comparar flotantes.
Desbordamiento de Enteros
Los enteros propios de Python pueden crecer tanto como haga falta, pero los enteros de NumPy tienen un tamaño fijo. Si un resultado no cabe, da la vuelta, y lo hace en silencio:
small = np.array([100, 120], dtype=np.int8)
print(small + small)
[-56 -16]
Un int8 solo puede guardar valores del -128 al 127, así que 100 + 100 dio la vuelta hasta -56, sin ningún error. El int64 predeterminado puede guardar números de hasta unos 9.2 trillones, así que rara vez te pasará, a menos que elijas un tipo pequeño o trabajes con imágenes (más abajo).
Ejemplos del Mundo Real
Cálculo Matricial y Resolver Ecuaciones
NumPy distingue la multiplicación elemento por elemento (*) de la multiplicación de matrices (@):
a = np.array([[1, 2], [3, 4]])
b = np.array([[5, 6], [7, 8]])
print(a * b)
print(a @ b)
[[ 5 12]
 [21 32]]
[[19 22]
 [43 50]]
El módulo np.linalg resuelve problemas de álgebra lineal. Supongamos que tres cafés y dos panes cuestan $70 para un grupo, y un café y cuatro panes cuestan $90 para otro. ¿Cuánto cuesta cada cosa?
coefficients = np.array([[3, 2], [1, 4]])
totals = np.array([70, 90])
solution = np.linalg.solve(coefficients, totals)
print(solution)
[10. 20.]
Un café cuesta $10 y un pan cuesta $20. (Comprobación: 3 × 10 + 2 × 20 = 70, y 10 + 4 × 20 = 90.)
Una Simulación Rápida: Lanzar Dados
Las simulaciones son un caso de uso clásico de NumPy. ¿Cuál es el total más probable al lanzar dos dados? En lugar de hacer las cuentas, lánzalos 100,000 veces:
rng = np.random.default_rng(seed=7)
rolls = rng.integers(1, 7, size=(100_000, 2))
totals = rolls.sum(axis=1)
counts = np.bincount(totals, minlength=13)[2:]
print(counts)
print((counts / len(totals)).round(3))
print(np.argmax(counts) + 2)
[ 2870  5457  8187 11046 13949 16663 13906 11266  8350  5535  2771]
[0.029 0.055 0.082 0.11  0.139 0.167 0.139 0.113 0.084 0.055 0.028]
7
np.bincount() cuenta cuántas veces apareció cada total. Los conteos son para los totales del 2 al 12, y forman la conocida forma de pirámide: el 7 es el total más común, y aparece alrededor del 16.7% de las veces, muy cerca de la probabilidad exacta de 1 entre 6. Los 200,000 lanzamientos de dados y el conteo tomaron una fracción de segundo.
Promedios Móviles
Un promedio móvil suaviza el ruido del día a día para mostrar una tendencia. Este es un promedio móvil de 3 días:
daily = np.array([120, 135, 150, 110, 190, 160, 175, 140])
window = 3
moving = np.convolve(daily, np.ones(window) / window, mode="valid")
print(moving.round(1))
[135. 131.7 150. 153.3 175. 158.3]
Cada valor es el promedio de tres días seguidos: (120 + 135 + 150) ÷ 3 = 135, y así sucesivamente. (Para datos con fechas, el rolling() de Pandas suele ser más cómodo.)
Las Imágenes Son Arreglos
Una imagen digital en escala de grises es simplemente un arreglo de dos dimensiones con valores de brillo del 0 (negro) al 255 (blanco), que normalmente se guardan como uint8 (enteros de 8 bits sin signo). Eso significa que editar imágenes es hacer cálculos con arreglos:
image = np.array([
    [ 10,  50,  90],
    [130, 170, 210],
    [250, 200, 150],
], dtype=np.uint8)
print(255 - image)
print(np.clip(image.astype(np.int16) + 80, 0, 255).astype(np.uint8))
[[245 205 165]
 [125  85  45]
 [  5  55 105]]
[[ 90 130 170]
 [210 250 255]
 [255 255 230]]
255 - image crea un negativo. Aclarar la imagen es más complicado por el desbordamiento: sumarle 80 a 250 daría la vuelta en uint8. Por eso primero la imagen se convierte a un tipo más grande (int16), se aclara y luego se recorta al rango válido con np.clip() antes de volver a convertirla. Una imagen a color funciona igual, con una tercera dimensión para los canales rojo, verde y azul.
Guardar y Cargar Arreglos
np.save("sales.npy", sales)
loaded = np.load("sales.npy")
print(np.array_equal(sales, loaded))
np.savetxt("sales.csv", sales, delimiter=",", fmt="%d")
print(np.loadtxt("sales.csv", delimiter=",", dtype=int)[0])
True
[120 135 150 110 190]
.npy es el formato binario propio de NumPy, rápido y exacto: ideal para guardar arreglos entre tus propios scripts. np.savetxt() y np.loadtxt() leen y escriben archivos de texto simple como CSV, que otros programas pueden abrir.
NumPy y Pandas
Pandas está construido sobre NumPy: cada columna de un DataFrame se respalda en un arreglo de NumPy. Puedes pasar de uno a otro con facilidad:
df["col"].to_numpy()convierte una columna de Pandas en un arreglo de NumPy.pd.DataFrame(array, columns=[...])convierte un arreglo en un DataFrame.- Las funciones de NumPy como
np.where()ynp.log()funcionan directamente con las columnas de Pandas.
Usa NumPy para cálculos rápidos con números: matrices, simulaciones, imágenes y cálculos científicos. Usa Pandas cuando tus datos tienen columnas con nombre de distintos tipos, fechas o valores faltantes que limpiar, como en Limpieza de Datos con Python Pandas. La mayoría de los proyectos de datos usan ambos. Para visualizar los resultados, consulta Visualización de Datos con Python.
Errores Comunes con NumPy
- Usar
and/oren lugar de&/|. Elandy elorde Python no funcionan con arreglos. Usa&,|y~, con paréntesis alrededor de cada condición. - Olvidar que las rebanadas son vistas. Cambiar una rebanada cambia el arreglo original. Usa
.copy()cuando necesites un arreglo independiente. - Confundir
*y@.*multiplica elemento por elemento;@es la multiplicación de matrices. - Confundir
axis=0yaxis=1. Recuerda:axises la dirección que se colapsa.axis=0da un resultado por columna;axis=1da un resultado por fila. - Difundir una fila cuando querías una columna. Un arreglo con forma
(3,)se alinea con las columnas, no con las filas. Usa la forma(3, 1)(okeepdims=True) para aplicar un valor por fila. - Ignorar los
nan. Un solo valor faltante hace quemean()devuelvanan. Usanp.nanmean()y sus similares. - Desbordar los tipos enteros pequeños, sobre todo con imágenes. Convierte a un tipo más grande antes de hacer los cálculos y luego recorta.
- Recorrer los arreglos con ciclos. Si estás escribiendo un ciclo
forsobre un arreglo de NumPy, casi siempre hay una forma vectorizada más rápida.
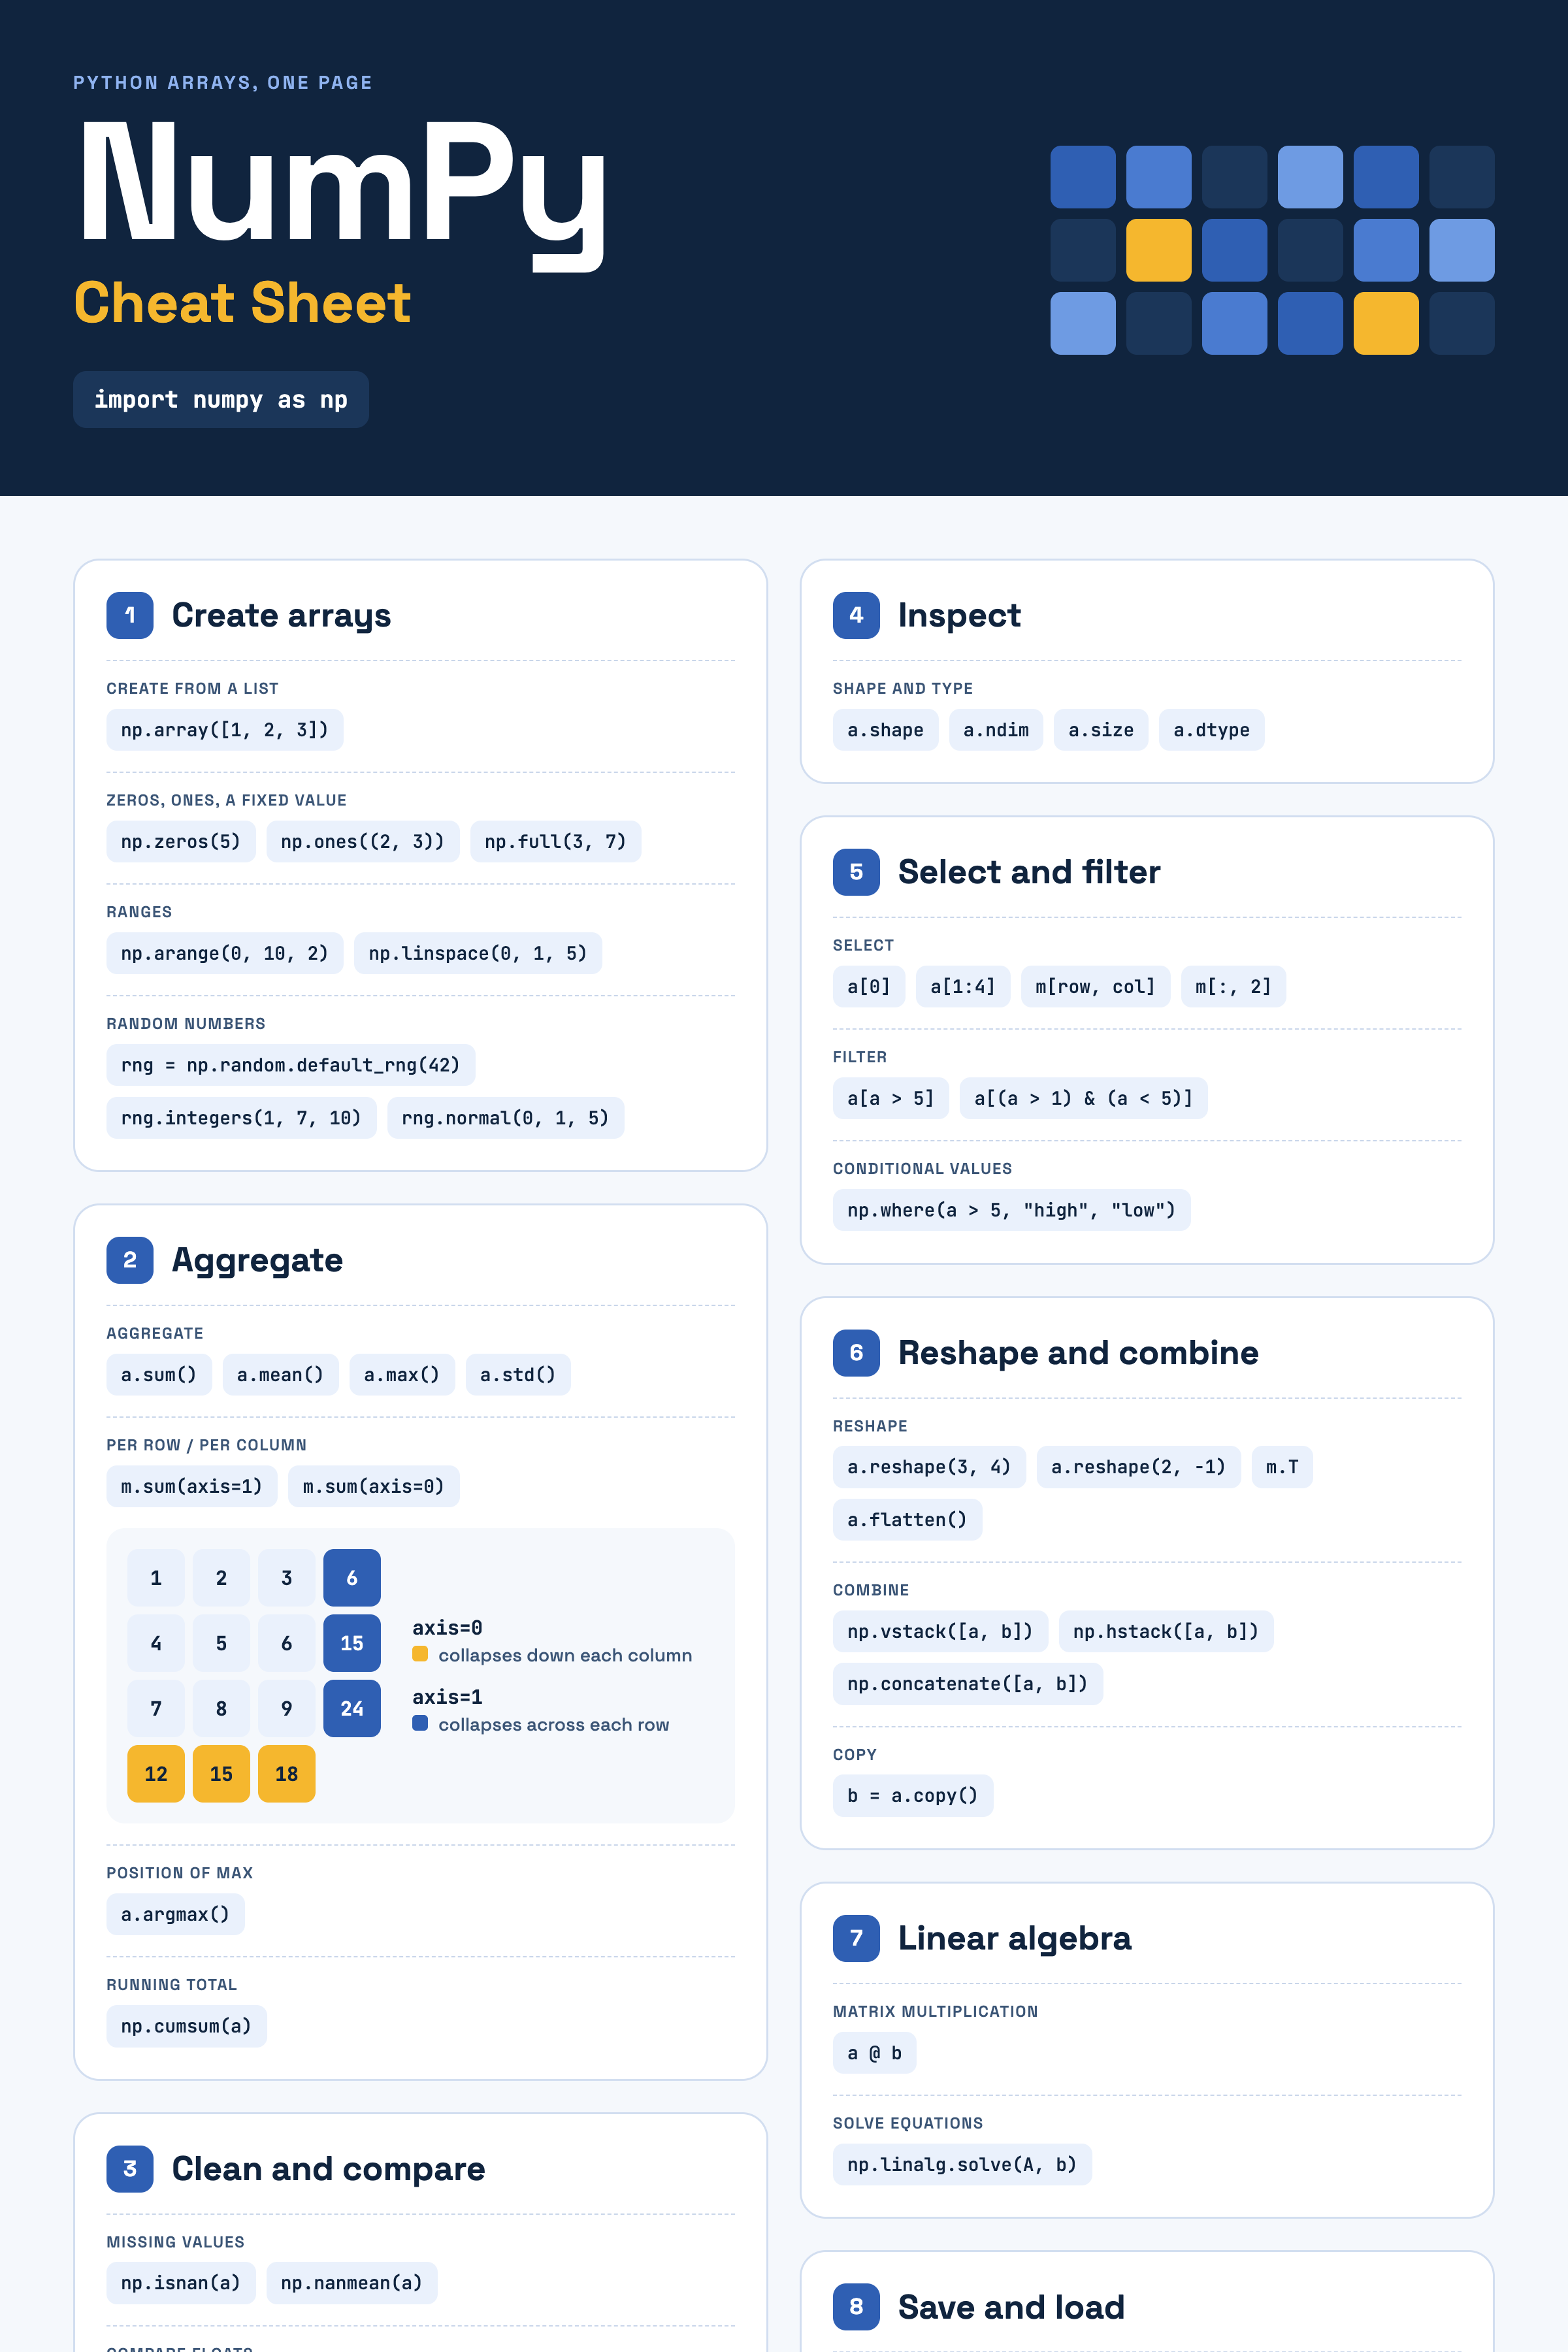
Hoja de Referencia de NumPy
| Tarea | Código |
|---|---|
| Crear a partir de una lista | np.array([1, 2, 3]) |
| Ceros, unos, un valor fijo | np.zeros(5), np.ones((2, 3)), np.full(3, 7) |
| Rangos | np.arange(0, 10, 2), np.linspace(0, 1, 5) |
| Números aleatorios | rng = np.random.default_rng(42), rng.integers(1, 7, 10), rng.normal(0, 1, 5) |
| Forma y tipo | a.shape, a.ndim, a.size, a.dtype |
| Seleccionar | a[0], a[1:4], m[fila, col], m[:, 2] |
| Filtrar | a[a > 5], a[(a > 1) & (a < 5)] |
| Valores condicionales | np.where(a > 5, "high", "low") |
| Agregar | a.sum(), a.mean(), a.max(), a.std() |
| Por fila / por columna | m.sum(axis=1), m.sum(axis=0) |
| Posición del máximo | a.argmax() |
| Total acumulado | np.cumsum(a) |
| Cambiar la forma | a.reshape(3, 4), a.reshape(2, -1), m.T, a.flatten() |
| Combinar | np.vstack([a, b]), np.hstack([a, b]), np.concatenate([a, b]) |
| Copiar | b = a.copy() |
| Valores faltantes | np.isnan(a), np.nanmean(a) |
| Comparar flotantes | np.isclose(a, b) |
| Multiplicación de matrices | a @ b |
| Resolver ecuaciones | np.linalg.solve(A, b) |
| Guardar y cargar | np.save("a.npy", a), np.load("a.npy") |
Descargar la hoja de referencia de NumPy (PNG)
Conclusión
NumPy convierte a Python en una herramienta rápida para trabajar con números. Sus arreglos guardan valores de un solo tipo de forma eficiente, así que las operaciones vectorizadas se aplican a millones de valores a la vez, decenas de veces más rápido que los ciclos. Puedes crear arreglos a partir de listas o con funciones como arange() y linspace(); seleccionar datos con índices, rebanadas y máscaras booleanas; resumirlos con agregaciones a lo largo de un eje; y combinar arreglos de formas distintas con el broadcasting.
Ten en cuenta los errores comunes (las rebanadas son vistas, los nan se propagan por los cálculos, los decimales necesitan np.isclose() y los tipos enteros pequeños pueden desbordarse) y tendrás la base sobre la que están construidos Pandas, Matplotlib, scikit-learn y el resto del ecosistema de datos de Python.