
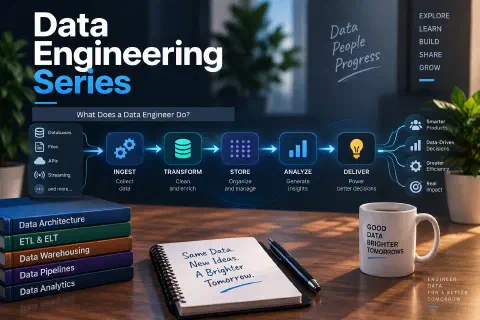
Serie Ingeniería de Datos, Parte 2 de 5. Anterior: ¿Qué Es un Ingeniero de Datos?
- ¿Qué Es un Ingeniero de Datos?
- ¿Qué Hace un Ingeniero de Datos? (estás aquí)
- Herramientas de Ingeniería de Datos: SQL, Python y Más
- ¿Qué Es un Pipeline de Datos?
- Cómo Ser Ingeniero de Datos
Un ingeniero de datos construye y mantiene pipelines de datos, diseña las bases de datos y almacenes donde se guardan los datos, mantiene la precisión de la información y automatiza los procesos que la entregan a quienes la necesitan. En otras palabras, se asegura de que los datos correctos lleguen al lugar correcto, en la forma correcta, a tiempo, todos los días.
En la Parte 1 aprendiste qué es la ingeniería de datos. Este artículo muestra cómo es el trabajo en la práctica: las responsabilidades, un día típico, el trabajo entre bastidores y las habilidades que necesitas.
Las Responsabilidades Principales
Los títulos y los equipos cambian, pero la mayoría de los ingenieros de datos son responsables de lo siguiente.
1. Construir y mantener pipelines de datos
Un pipeline de datos es un proceso automatizado que mueve datos de un origen a un destino y los prepara en el camino. Los ingenieros de datos diseñan estos pipelines, escriben el código, los prueban y los reparan cuando fallan. La Parte 4 cubre los pipelines a fondo.
2. Diseñar bases de datos y modelos de datos
Deciden cómo se organizan los datos: qué tablas existen, cómo se relacionan, qué contiene cada columna y cómo hacer rápidas las consultas. Un buen diseño evita duplicados, inconsistencias y reportes lentos. Mira el diseño de bases de datos para los fundamentos.
3. Extraer, transformar y cargar datos (ETL y ELT)
Los ingenieros de datos extraen datos de las fuentes, los limpian y reorganizan (transformar) y los guardan en un destino (cargar), en el orden ETL o ELT. Los detalles están en ETL vs ELT.
4. Asegurar la calidad de los datos
Los datos malos llevan a malas decisiones, así que los ingenieros agregan controles que detectan problemas a tiempo: valores faltantes, duplicados, formatos incorrectos y números imposibles. Verás un ejemplo más abajo.
5. Automatizar y programar
Nadie debería ejecutar procesos de datos a mano cada mañana. Los ingenieros programan los pipelines para que corran a tiempo, se reintenten cuando algo falla y avisen al equipo cuando un problema necesita atención.
6. Optimizar el rendimiento y el costo
Las consultas que eran rápidas en una tabla pequeña pueden arrastrarse en una grande, y el almacenamiento y el cómputo en la nube cuestan dinero. Los ingenieros afinan consultas, eligen almacenamiento eficiente y evitan el desperdicio. Mira por qué tu consulta SQL es lenta.
7. Proteger y gobernar los datos
Los datos suelen incluir información personal o sensible. Los ingenieros controlan quién puede acceder a ellos, los cifran y siguen las reglas de privacidad. Mira seguridad y privacidad de bases de datos y privacidad de datos para empresas.
8. Colaborar y documentar
Los ingenieros de datos trabajan con analistas, científicos de datos, desarrolladores de software y equipos de negocio para entender qué datos necesitan. También documentan cómo funcionan los pipelines, para que otros puedan entenderlos y mantenerlos.
Un Día en la Vida
Cada equipo es distinto, pero un día típico puede verse así:
| Hora | Actividad |
|---|---|
| Mañana | Verificar que los pipelines nocturnos terminaron y revisar alertas o fallos |
| Media mañana | Investigar un proceso fallido: un archivo de origen cambió de formato y rompió la transformación, así que se corrige y se vuelve a ejecutar |
| Antes del mediodía | Reunirse con analistas que necesitan un nuevo conjunto de datos para un reporte de ventas |
| Tarde | Construir el nuevo pipeline, escribiendo SQL y Python, con pruebas |
| Última hora de la tarde | Revisar el código de un compañero y afinar una consulta lenta que retrasa un dashboard |
| Fin del día | Actualizar la documentación y planear el trabajo de mañana |
Nota cuánto del trabajo es mantenimiento y resolución de problemas, no solo construir cosas nuevas.
Trabajar con Bases de Datos
Las bases de datos están en el centro del trabajo. Los ingenieros de datos escriben SQL todos los días para crear tablas, cargar y transformar datos, y verificar resultados. Trabajan con bases de datos relacionales como PostgreSQL y MySQL, y con data warehouses en la nube hechos para el análisis. Si eres nuevo en esto, empieza con PostgreSQL para principiantes y aprende los JOIN de SQL y las funciones de ventana.
Automatización y Programación de Tareas
Un pipeline que solo corre cuando alguien se acuerda de iniciarlo no es un pipeline. Los ingenieros usan programadores y herramientas de orquestación para ejecutar procesos según un horario, en el orden correcto y con reintentos.
El programador más simple es cron en Linux. Esta línea ejecuta un script todas las noches a las 2:00 AM:
0 2 * * * /usr/bin/python3 /opt/pipelines/orders.py
Las herramientas de orquestación más avanzadas manejan dependencias (“ejecuta el proceso B solo después de que A termine bien”), reintentos, registros y alertas. La Parte 3 lista las más comunes. Para automatización de negocio sin código, herramientas como Power Automate cubren una necesidad parecida a menor escala.
Calidad de Datos en la Práctica
Este es un pequeño ejemplo del tipo de verificación que escribe un ingeniero de datos. Revisa una tabla de pedidos e informa qué reglas fallan:
import pandas as pd

orders = pd.DataFrame({
    "order_id": [1, 2, 2, 4],
    "customer": ["Ana", "Luis", "Luis", None],
    "amount": [35.5, 120.0, 120.0, -5.0],
})

checks = {
    "table has rows": len(orders) > 0,
    "no missing customers": orders["customer"].notna().all(),
    "order_id is unique": orders["order_id"].is_unique,
    "amount is not negative": (orders["amount"] >= 0).all(),
}

for name, passed in checks.items():
    print("PASS" if passed else "FAIL", "-", name)

failed = [name for name, passed in checks.items() if not passed]
if failed:
    print(f"{len(failed)} check(s) failed")
Resultado:
PASS - table has rows
FAIL - no missing customers
FAIL - order_id is unique
FAIL - amount is not negative
3 check(s) failed
En un pipeline real, una verificación fallida detendría el proceso o enviaría una alerta, para que los datos malos nunca lleguen a un dashboard. Puedes ejecutar el mismo tipo de verificación directamente en SQL. Por ejemplo, esto encuentra IDs de pedido duplicados:
SELECT order_id, COUNT(*) AS copies
FROM orders
GROUP BY order_id
HAVING COUNT(*) > 1;
Para aprender más sobre limpieza, mira limpiar datos desordenados con SQL y limpieza de datos con Pandas.
Monitoreo y Confiabilidad
Los pipelines fallan por razones comunes: un servidor se cae, un archivo llega tarde, una API cambia o el volumen de datos se duplica de repente. Los ingenieros agregan:
- Registros (logs), para ver qué pasó y cuándo.
- Alertas, para que el equipo sepa pronto cuando algo se rompe.
- Reintentos, para que los problemas temporales se arreglen solos.
- Respaldos y planes de recuperación, para poder restaurar los datos. Mira la recuperación ante desastres.
La idea es parecida a monitorear un sitio web, como en la guía de Uptime Kuma, pero aplicada a los procesos de datos.
Habilidades que Necesita un Ingeniero de Datos
| Habilidades técnicas | Habilidades blandas |
|---|---|
| SQL para consultar y transformar datos | Resolución de problemas para encontrar por qué algo falló |
| Python para automatización y procesamiento de datos | Comunicación con personas técnicas y no técnicas |
| Bases de datos y modelado de datos | Atención al detalle, porque los errores pequeños se propagan |
| Plataformas en la nube y nociones de redes | Curiosidad para aprender nuevas herramientas |
| Git para el control de versiones | Colaboración y disposición para documentar |
| Línea de comandos de Linux y nociones de Docker | Paciencia con datos desordenados e impredecibles |
Si quieres empezar a construirlas, prueba los fundamentos de Python, Git y Docker.
Cómo Cambia el Rol Según la Empresa
- Empresas pequeñas y startups: a menudo eres generalista. Una persona puede construir pipelines, diseñar la base de datos y hacer dashboards.
- Empresas grandes: los roles son especializados. Un equipo puede manejar la ingesta, otro el data warehouse y otro la plataforma y las herramientas.
- La industria también importa: la salud y las finanzas tienen reglas estrictas de seguridad y privacidad, mientras que el comercio electrónico puede enfocarse en la velocidad y los grandes volúmenes.
Desafíos Comunes
- Fuentes desordenadas. Los datos llegan con valores faltantes, formatos inconsistentes y sorpresas.
- Esquemas que cambian. Un sistema de origen agrega o renombra una columna y tu pipeline se rompe.
- Fallos silenciosos. Un proceso “termina bien” pero carga datos incompletos, lo cual es peor que fallar de forma visible.
- Escala. Algo que funcionaba con miles de filas se vuelve lento con millones.
- Costo. Los recursos en la nube se acumulan si no se administran.
Los buenos hábitos de ingeniería (pruebas, monitoreo, documentación) son la forma en que los ingenieros con experiencia manejan todo esto.
Preguntas Frecuentes
¿Qué hace un ingeniero de datos todos los días?
Monitorea y repara pipelines, escribe SQL y Python para mover y transformar datos, diseña o mejora bases de datos, revisa código y trabaja con analistas y desarrolladores para entregar los datos que la gente necesita.
¿Los ingenieros de datos crean dashboards?
Normalmente no. Preparan los datos y los ponen a disposición, y los analistas o desarrolladores de BI crean los dashboards. En equipos pequeños, una persona puede hacer ambas cosas.
¿Cuál es la diferencia entre ETL e ingeniería de datos?
ETL (extraer, transformar, cargar) es un proceso que construyen los ingenieros de datos. La ingeniería de datos es el campo más amplio que también cubre bases de datos, automatización, calidad, rendimiento y seguridad.
¿Los ingenieros de datos necesitan saber aprendizaje automático?
No necesariamente. Algo de conocimiento ayuda, ya que a menudo preparan datos para modelos, pero crear modelos es principalmente trabajo de un científico de datos. Mira ¿Qué Es la Ciencia de Datos?.
¿Cuánto SQL necesita un ingeniero de datos?
Mucho. SQL es la habilidad central, desde consultas básicas y joins hasta funciones de ventana, ajuste de rendimiento y modelado de datos.
¿La ingeniería de datos es estresante?
Puede serlo cuando se rompe un pipeline y la gente espera los datos. Un buen monitoreo, pruebas y documentación clara reducen ese estrés.
Conclusión
El trabajo de un ingeniero de datos es hacer que los datos sean confiables y estén disponibles: construir pipelines, diseñar bases de datos, verificar la calidad, automatizar procesos y mantener todo funcionando sin problemas. El trabajo combina programación, bases de datos y resolución de problemas, y apoya casi todo lo que hace un analista o un científico de datos.
En la Parte 3 conocerás las herramientas detrás del trabajo: Herramientas de Ingeniería de Datos: SQL, Python y Más.
Siguiente en la serie Ingeniería de Datos: Herramientas de Ingeniería de Datos: SQL, Python y Más