
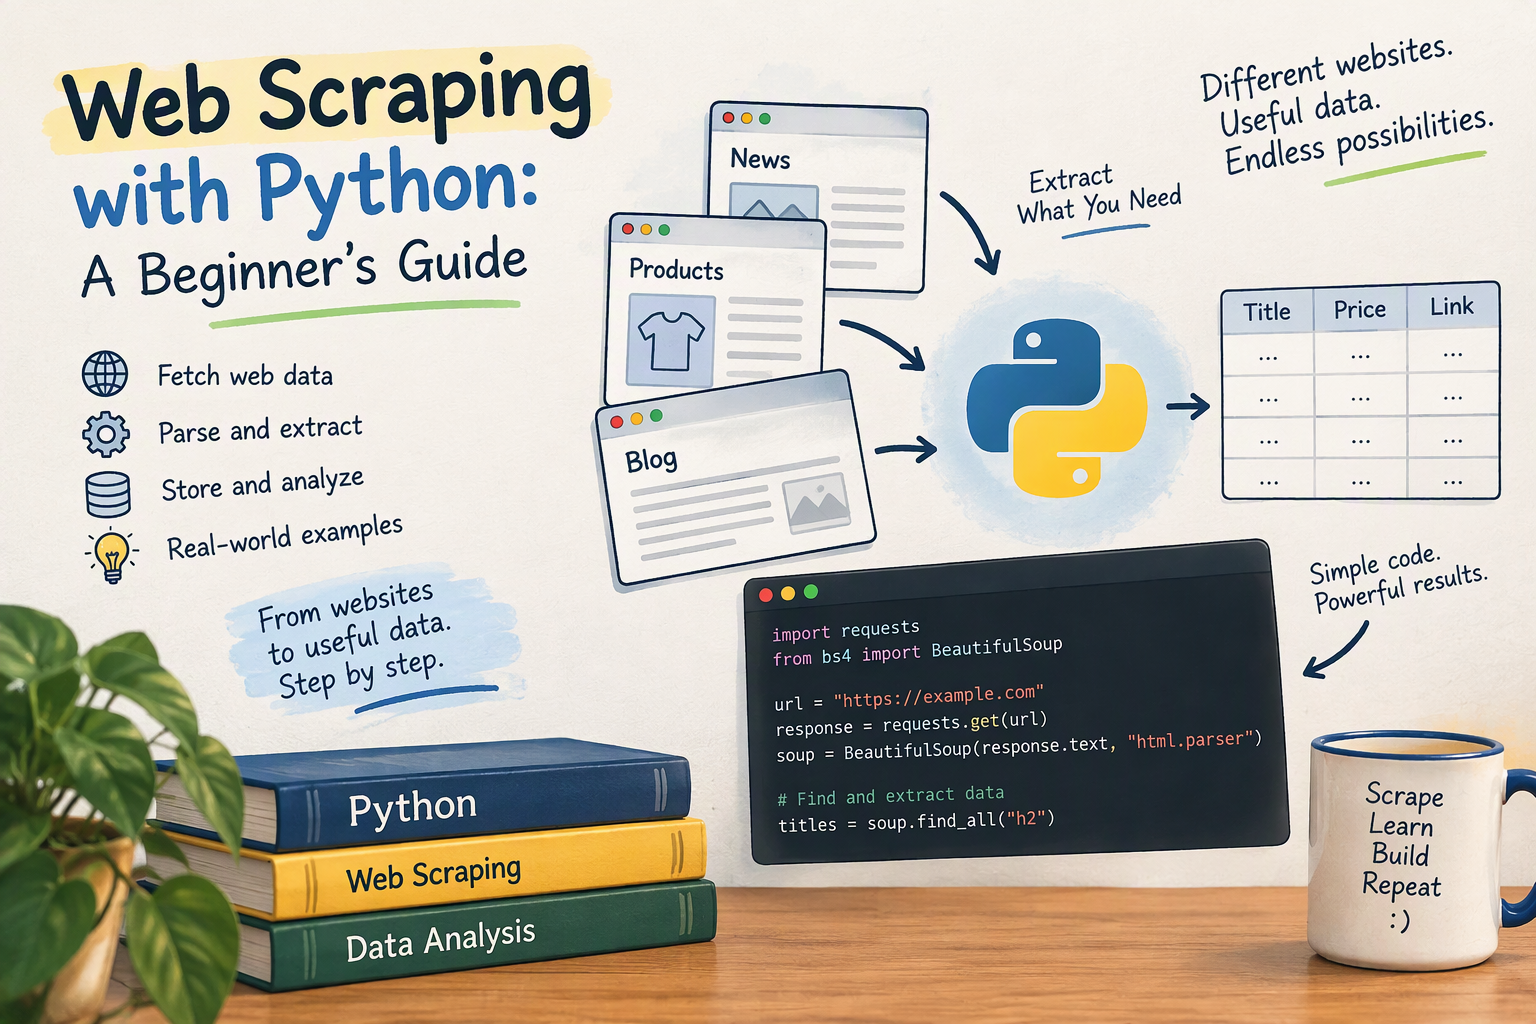
A veces los datos que necesitas están en una página web, pero no hay botón de descarga ni API. Quizás es una lista de precios de productos, una tabla de resultados deportivos o un directorio de negocios. Podrías copiarlos y pegarlos a mano, pero eso se vuelve tedioso después de unas diez filas.
El web scraping es la solución: un programa corto de Python visita la página, lee el HTML, selecciona las partes que te interesan y las guarda en un archivo ordenado. En esta guía construirás un scraper funcional desde cero, paso a paso, y aprenderás a hacerlo de forma respetuosa y legal.
¿Qué Es el Web Scraping?
El web scraping es el proceso automatizado de recopilar datos de páginas web. Un scraper hace lo mismo que tu navegador: solicita una página y recibe HTML. Pero en lugar de mostrarla en pantalla, el programa lee el HTML y extrae las piezas que le pides.
Usos comunes:
- Seguir precios en tiendas en línea
- Recopilar ofertas de empleo o anuncios inmobiliarios
- Reunir datos para investigación o proyectos de análisis de datos
- Monitorear titulares de noticias o blogs
- Crear un conjunto de datos pequeño para practicar
Antes de Hacer Scraping: Revisa las Reglas
El scraping es una herramienta y puede usarse mal. Antes de extraer datos de cualquier sitio, revisa lo siguiente:
- Busca primero una API. Si el sitio ofrece una API oficial o un conjunto de datos descargable, úsalo. Es más confiable y está permitido.
- Lee los Términos de Servicio. Algunos sitios prohíben el acceso automatizado.
- Revisa
robots.txt. Visitahttps://example.com/robots.txtpara ver qué rutas el sitio pide que los bots no visiten. - Sé amable. Haz pausas entre solicitudes para no sobrecargar el servidor. Un scraper que bombardea un sitio pequeño puede parecer un ataque.
- Evita datos personales. No recopiles información privada de personas, y nunca extraigas contenido detrás de un inicio de sesión que no estés autorizado a usar.
- Identifícate. Envía un
User-Agentdescriptivo para que los dueños del sitio sepan quién los visita.
Para practicar, esta guía usa books.toscrape.com, una librería ficticia creada específicamente para aprender scraping. Es seguro y legal usarla.
Paso 1: Configura tu Entorno
Necesitas tener Python 3 instalado. Crea una carpeta de proyecto y un entorno virtual para aislar los paquetes (consulta entornos virtuales de Python para más detalles):
mkdir scraper-demo
cd scraper-demo
python -m venv venv
Actívalo:
# macOS / Linux
source venv/bin/activate

# Windows (PowerShell)
venv\Scripts\Activate.ps1
Instala las dos bibliotecas que necesitas:
pip install requests beautifulsoup4
- Requests descarga páginas web.
- Beautiful Soup (
beautifulsoup4) analiza el HTML para que puedas buscar dentro de él.
Paso 2: Entiende la Página que Quieres Extraer
El scraping depende de entender HTML. Si necesitas un repaso, lee cómo usar HTML y CSS.
Abre https://books.toscrape.com en tu navegador, haz clic derecho sobre el título de un libro y elige Inspeccionar. Esto abre las herramientas de desarrollo y muestra el HTML detrás de la página. Verás que cada libro se ve más o menos así:
<article class="product_pod">
  <h3><a href="catalogue/a-light-in-the-attic_1000/index.html" title="A Light in the Attic">A Light in the ...</a></h3>
  <div class="product_price">
    <p class="price_color">£51.77</p>
  </div>
</article>
Observa el patrón: cada libro es un <article> con la clase product_pod, el título completo está en el atributo title del enlace, y el precio está en un párrafo con la clase price_color. Tu scraper usará estas etiquetas y clases como señales.
Paso 3: Descarga la Página
Crea un archivo llamado scrape.py y empieza descargando la página:
import requests

URL = "https://books.toscrape.com/"
headers = {"User-Agent": "learning-scraper/1.0 (personal practice project)"}

response = requests.get(URL, headers=headers, timeout=10)
response.raise_for_status()  # detiene el script con un error si la solicitud falló

print(response.status_code)
print(response.text[:300])
Ejecútalo con python scrape.py. Un código de estado 200 significa éxito, y deberías ver el comienzo del HTML de la página. raise_for_status() convierte errores como 404 o 500 en excepciones claras de Python, en lugar de dejar que tu script continúe en silencio con datos incorrectos.
Paso 4: Analiza el HTML con Beautiful Soup
Ahora entrega el HTML a Beautiful Soup y extrae los libros:
from bs4 import BeautifulSoup

soup = BeautifulSoup(response.text, "html.parser")

for book in soup.select("article.product_pod"):
    title = book.h3.a["title"]
    price = book.select_one("p.price_color").get_text(strip=True)
    print(title, price)
Esto es lo que sucede:
soup.select("article.product_pod")usa un selector CSS para encontrar todos los libros de la página. Si conoces CSS, te resultará familiar.book.h3.a["title"]lee el atributotitledel enlace dentro del<h3>.select_one(...)devuelve la primera coincidencia, y.get_text(strip=True)devuelve su texto sin espacios extra.
Ejecuta el script otra vez y deberías ver una lista de 20 títulos de libros con sus precios.
Paso 5: Extrae Varias Páginas
El sitio tiene 50 páginas de libros. La mayoría tiene un botón “next” (siguiente), así que un buen enfoque es seguir ese enlace hasta que no haya más páginas. Este es el script completo, con una pausa cortés entre solicitudes:
import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

START_URL = "https://books.toscrape.com/"
HEADERS = {"User-Agent": "learning-scraper/1.0 (personal practice project)"}


def scrape_page(url):
    response = requests.get(url, headers=HEADERS, timeout=10)
    response.raise_for_status()
    soup = BeautifulSoup(response.text, "html.parser")

    books = []
    for book in soup.select("article.product_pod"):
        books.append({
            "title": book.h3.a["title"],
            "price": book.select_one("p.price_color").get_text(strip=True),
        })

    next_link = soup.select_one("li.next a")
    next_url = urljoin(url, next_link["href"]) if next_link else None
    return books, next_url


all_books = []
url = START_URL
while url:
    print(f"Scraping {url}")
    books, url = scrape_page(url)
    all_books.extend(books)
    time.sleep(1)  # sé amable: espera un segundo entre solicitudes

print(f"Collected {len(all_books)} books")
urljoin construye una dirección web completa a partir del enlace relativo del botón “next”, así que no tienes que armar las URL a mano. Cuando la última página no tiene botón “next”, next_url pasa a ser None y el ciclo termina.
Paso 6: Guarda los Datos en un Archivo CSV
Los datos en memoria desaparecen cuando el script termina. Guardarlos en un archivo CSV te permite abrirlos en Excel o analizarlos después:
import csv

with open("books.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["title", "price"])
    writer.writeheader()
    writer.writerows(all_books)
Agrégalo al final de tu script. Al ejecutarlo se crea books.csv en la carpeta de tu proyecto. Desde ahí puedes cargarlo en Pandas y continuar con la limpieza de datos con Python Pandas. Los precios son texto como £51.77, así que quitar el símbolo y convertirlos a números es un ejercicio de limpieza perfecto para empezar.
Problemas Comunes y Cómo Solucionarlos
| Problema | Causa probable | Qué intentar |
|---|---|---|
| Tus resultados están vacíos | El selector no coincide con el HTML | Revisa de nuevo la página con Inspeccionar; prueba tu selector en la consola del navegador |
Recibes un error 403 Forbidden | El sitio bloquea bots desconocidos | Define un User-Agent claro; si el sitio aún te rechaza, respétalo |
| Los datos que ves en el navegador no están en tu HTML | La página carga los datos con JavaScript | Busca una API oculta en la pestaña Network del navegador, o usa una herramienta de automatización de navegador |
429 Too Many Requests | Vas demasiado rápido | Agrega pausas más largas entre solicitudes |
| Caracteres extraños en el texto | Problema de codificación | Guarda los archivos con encoding="utf-8" |
| El script falla cuando el sitio se rediseña | Los selectores dependen del diseño del HTML | Los scrapers necesitan mantenimiento ocasional; usa una API cuando puedas |
Cuando Beautiful Soup No Es Suficiente
Beautiful Soup solo ve el HTML que envía el servidor. Algunos sitios modernos construyen su contenido en tu navegador con JavaScript, así que los datos nunca aparecen en el HTML descargado. En ese caso tienes algunas opciones:
- Busca la API de los datos. Abre las herramientas de desarrollo de tu navegador, ve a la pestaña Network y recarga la página. A menudo la página solicita datos JSON limpios que puedes pedir directamente, lo cual es más fácil que extraer HTML.
- Usa una herramienta de automatización de navegador como Selenium o Playwright. Controlan un navegador real, por lo que el JavaScript se ejecuta igual que para un visitante humano. Son más lentas y complejas, así que úsalas solo cuando sea necesario.
- Usa un framework de scraping como Scrapy cuando necesites rastrear miles de páginas con limitación de velocidad, reintentos y herramientas de exportación integradas.
Lista de Buenas Prácticas
- Prefiere una API oficial o un conjunto de datos descargable en lugar del scraping.
- Respeta
robots.txty los términos del sitio. - Agrega pausas e identifica tu scraper con un
User-Agent. - Maneja errores con
raise_for_status()y tiempos de espera para que tu script no se quede colgado. - Guarda en caché las páginas que ya descargaste durante el desarrollo, para no solicitarlas una y otra vez.
- Extrae solo lo que necesitas y almacénalo de forma responsable.
- Mantén tu código en funciones pequeñas para actualizarlo fácilmente cuando el sitio cambie.
Conclusión
El web scraping convierte la web en una fuente de datos. Con Requests para descargar páginas y Beautiful Soup para leer el HTML, puedes recopilar listas, precios, titulares y más en menos de cincuenta líneas de Python. La receta es siempre la misma: inspeccionar la página, encontrar el patrón, extraer los datos, guardarlos y hacerlo con respeto.
Practica en un sitio hecho para el scraping, como books.toscrape.com, antes de apuntar tu scraper a sitios reales. Cuando te sientas cómodo, intenta recopilar un pequeño conjunto de datos que te interese y analizarlo con Pandas. Si el lenguaje es nuevo para ti, comienza con Fundamentos de Python: Lo que Todo Principiante Debe Saber y la guía de 10 bibliotecas de Python que todo principiante debe conocer.